

LLM 에이전트 팀 구성 방법, 처음에는 관리자 1명과 전문 에이전트 2~4명으로 시작하세요
LLM 에이전트 팀을 처음 설계할 때 필요한 Manager·전문 Agent·Reviewer 역할 분리부터 handoff, 병렬 실행, 메모리, 도구 권한, 종료 조건까지 실제 구성 순서로 설명합니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
관련 상품을 불러오고 있습니다…
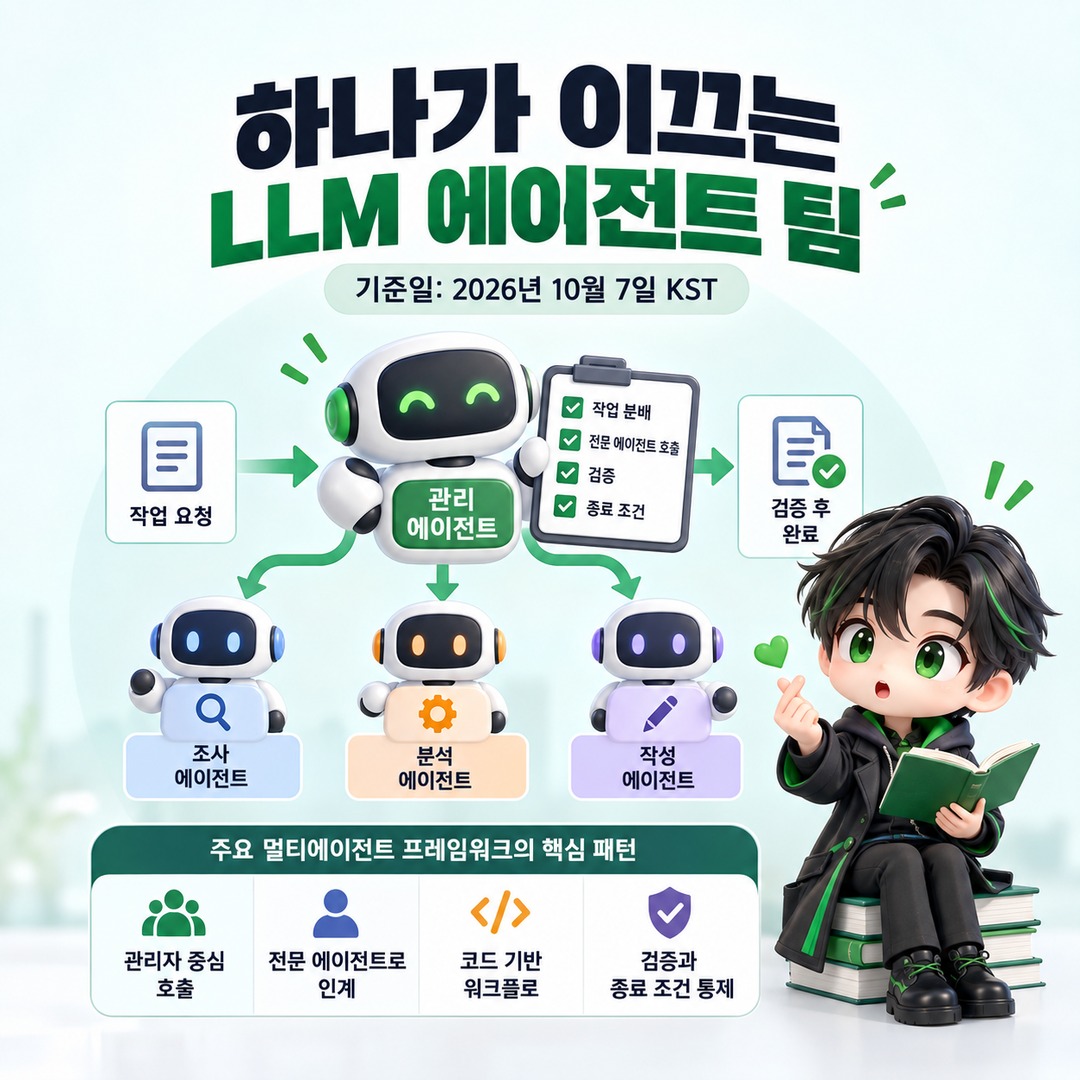
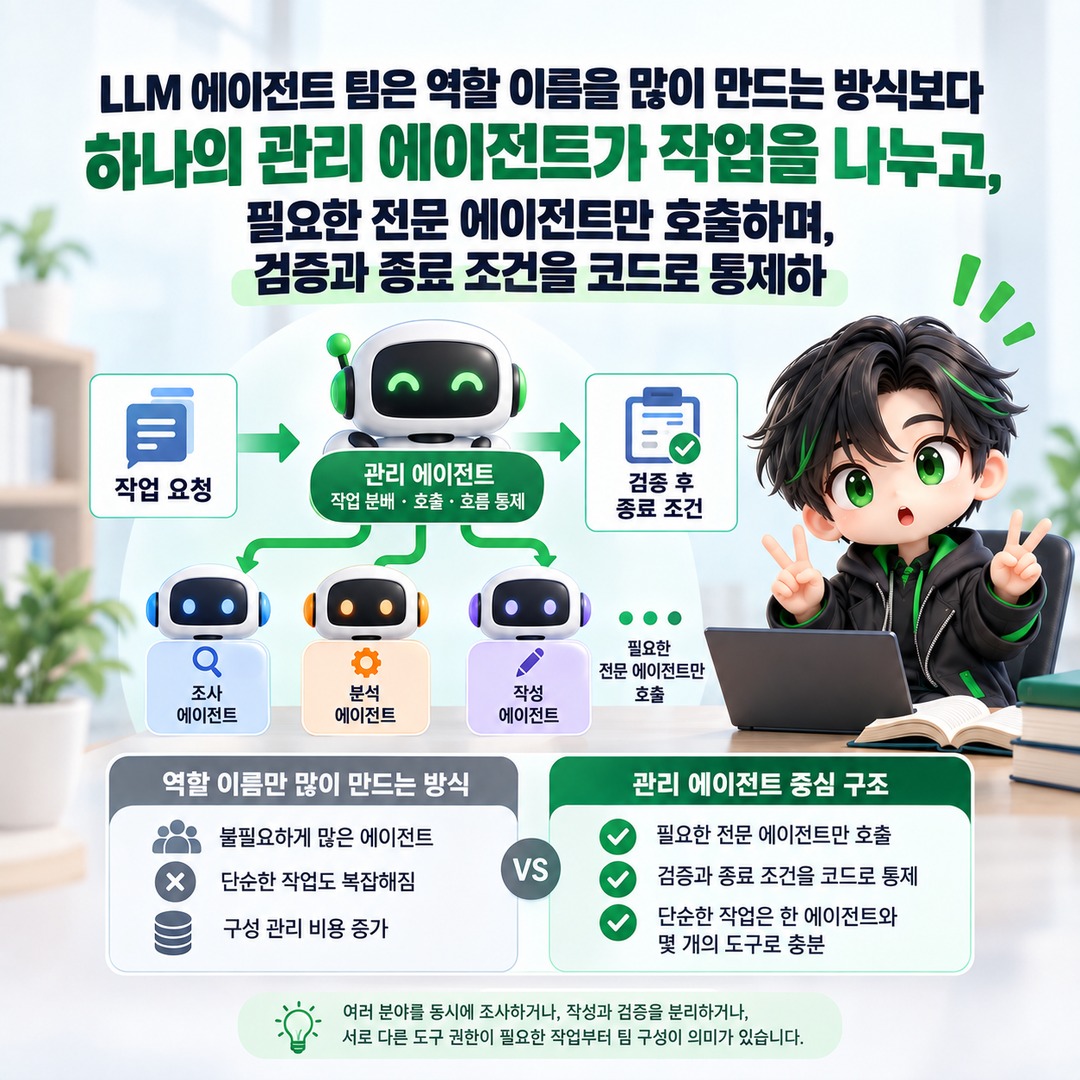
LLM 에이전트 팀은 역할 이름을 많이 만드는 방식보다 하나의 관리 에이전트가 작업을 나누고, 필요한 전문 에이전트만 호출하며, 검증과 종료 조건을 코드로 통제하는 구조가 실용적입니다. 주요 멀티에이전트 프레임워크도 관리자 중심 호출, 전문 에이전트로의 인계, 코드 기반 워크플로를 핵심 패턴으로 제공하고 있습니다.
단순한 질문까지 여러 에이전트에게 맡길 필요는 없습니다. 한 에이전트와 몇 개의 도구로 충분한 작업이라면 그 구성이 더 단순하고 저렴합니다. 여러 분야를 동시에 조사하거나, 작성과 검증을 분리하거나, 서로 다른 도구 권한이 필요한 작업부터 팀 구성이 의미가 있습니다.
기준일: 2026년 10월 7일 KST
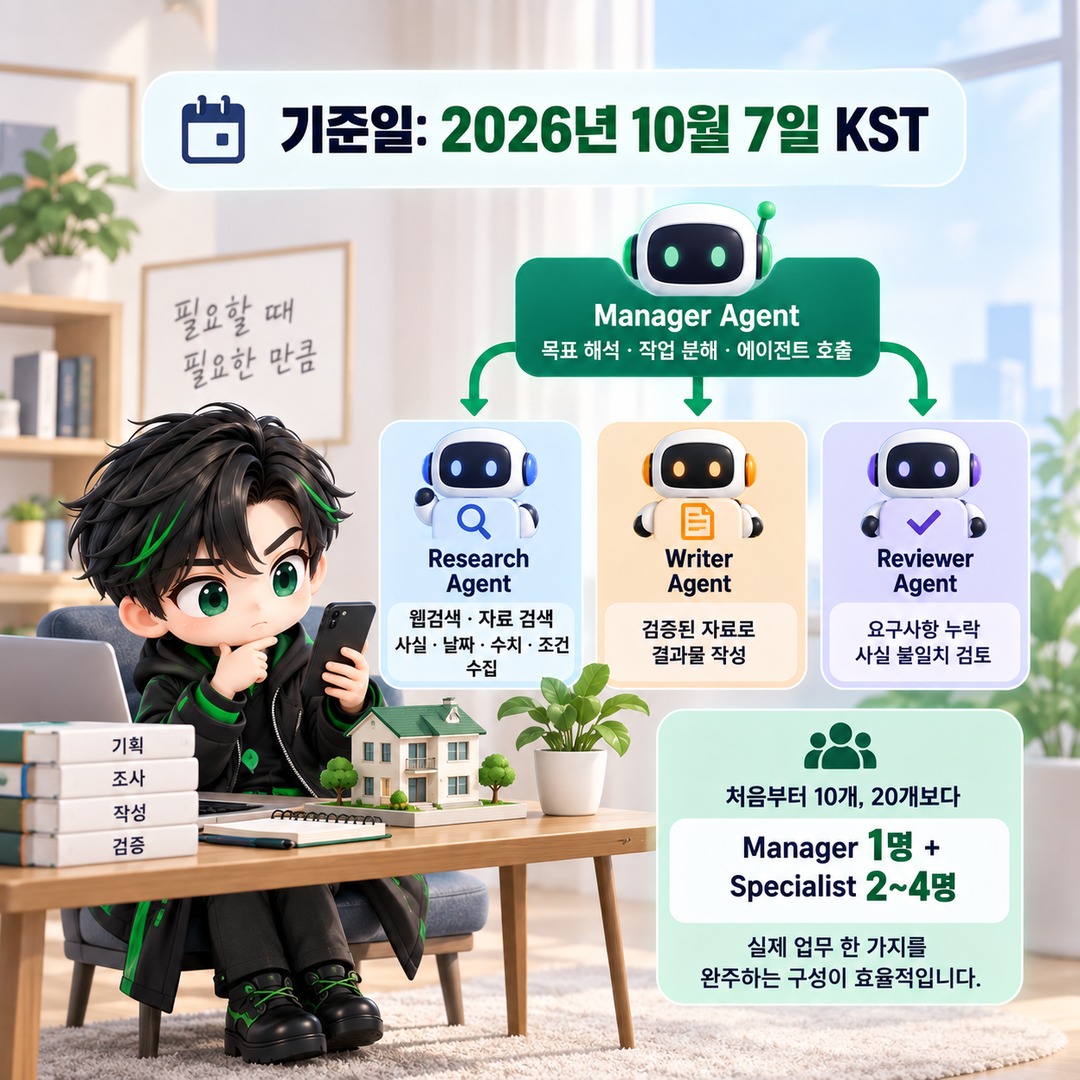
처음부터 10개, 20개의 에이전트를 만드는 것보다 Manager 1명 + Specialist 2~4명 정도로 실제 업무 한 가지를 완주하는 편이 좋습니다. 에이전트 수는 조직도의 직책 수가 아니라 동시에 분리해야 할 작업과 권한의 수를 기준으로 결정해야 합니다.
예를 들어 자동 콘텐츠 제작 시스템이라면 다음 정도에서 시작할 수 있습니다.
1. Manager Agent
사용자의 목표를 해석하고 작업을 분해합니다. 어떤 에이전트를 호출할지 결정하고 중간 결과를 모아 다음 단계로 넘깁니다.
2. Research Agent
웹검색이나 내부 자료 검색을 담당합니다. 사실·날짜·수치·조건을 수집하지만 최종 원고를 임의로 확정하지 않습니다.
3. Writer Agent
검증된 자료를 받아 실제 결과물을 작성합니다. 조사 범위를 벗어난 사실을 새로 만드는 권한은 주지 않는 편이 관리하기 쉽습니다.
4. Reviewer Agent
요구사항 누락, 사실 불일치, 형식 오류 등을 검사하고 통과 또는 수정 필요 상태를 반환합니다.
필요한 경우에만 Publisher, Coding, Data Analysis 같은 전문 역할을 추가합니다.
이 구조에서 중요한 것은 네 에이전트가 모두 자유롭게 대화하도록 만드는 것이 아닙니다. 누가 작업을 시작하고, 누구에게 무엇을 전달하며, 누가 최종 결과를 확정하는지가 명확해야 합니다.
Manager Agent의 핵심 역할은 분해·배정·상태 관리·종료 판단입니다. 전문 작업까지 Manager에게 몰아주면 결국 이름만 멀티에이전트이고 실제로는 하나의 거대한 프롬프트가 됩니다.
OpenAI Agents SDK는 대표적인 구성으로 두 방식을 구분합니다. 하나는 Manager가 전문 에이전트를 도구처럼 호출하면서 최종 통제권을 유지하는 방식이고, 다른 하나는 적절한 전문 에이전트에게 대화의 제어권을 넘기는 handoff 방식입니다. 코드에서 실행 순서를 직접 결정하는 오케스트레이션도 함께 사용할 수 있습니다.
예를 들어 사용자가 “오늘 정책 변화를 조사해서 글을 작성해 줘”라고 요청했다면 다음처럼 흐름을 제한할 수 있습니다.
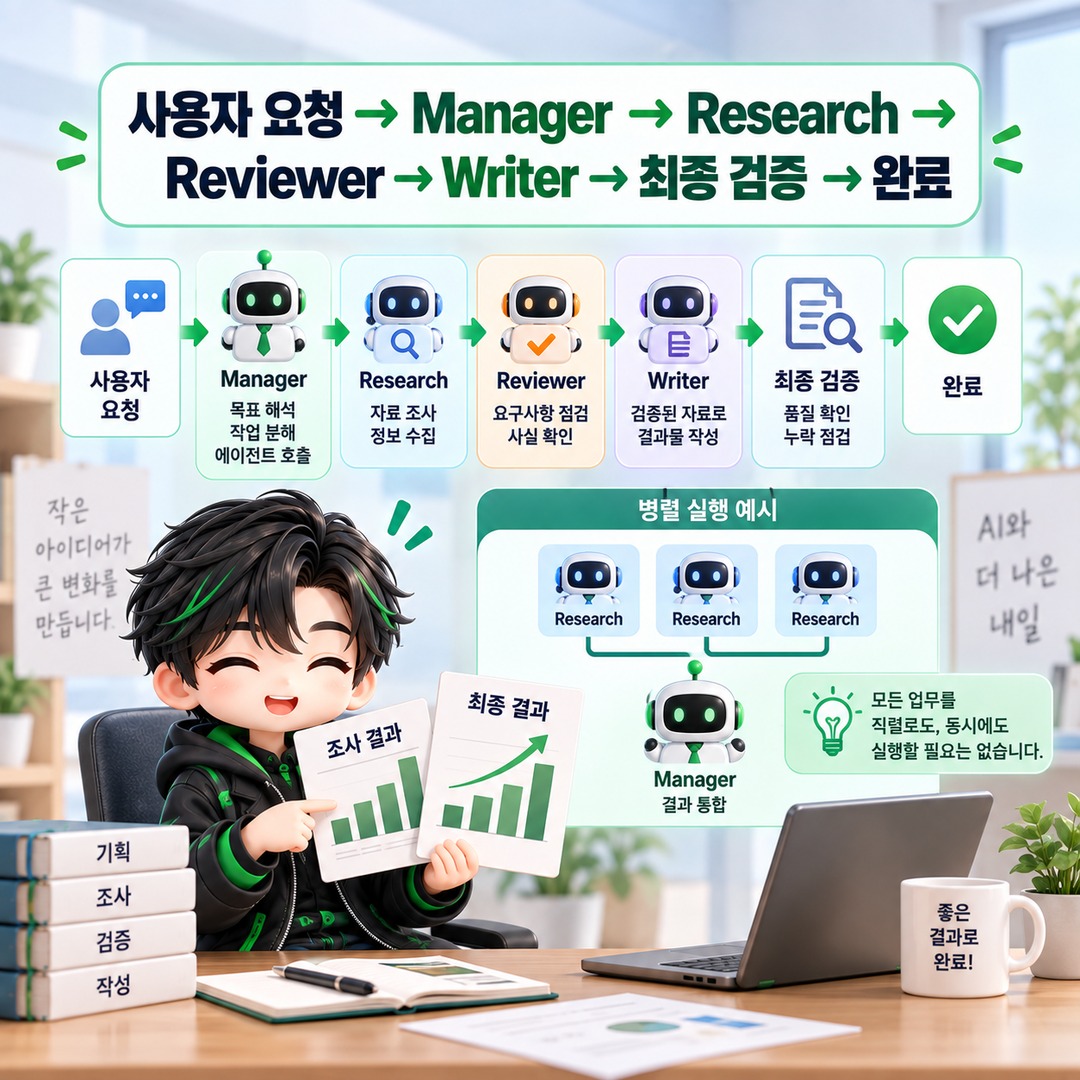
사용자 요청 → Manager → Research → Reviewer → Writer → 최종 검증 → 완료
반면 서로 의존하지 않는 세 분야를 조사해야 한다면 Research Agent 세 개를 병렬로 실행한 뒤 Manager가 결과를 합치는 구조가 가능합니다.
즉, 모든 업무를 직렬로 연결할 필요도 없고 모든 에이전트를 동시에 실행할 필요도 없습니다.
“마케팅 전문가”, “AI 전문가”, “천재 분석가”처럼 넓은 역할보다 입력과 출력이 명확하게 구분되는 작업 단위가 운영하기 쉽습니다.
Research Agent라면 “자료를 조사한다”에서 끝내지 말고 어떤 입력을 받고 무엇을 반환해야 하는지까지 정합니다.
예를 들어 입력은 `research_topic`, `date`, `required_fields`이고 결과는 `verified_facts`, `unknowns`, `source_records`처럼 구조화할 수 있습니다.
Writer Agent에는 검색 도구가 필요하지 않을 수도 있습니다. 검증된 FACT CORE만 입력받도록 만들면 Writer가 별도로 검색해 서로 다른 수치를 가져오는 흐름을 줄일 수 있습니다.
Anthropic이 공개한 멀티에이전트 Research 구조에서도 리드 에이전트가 작업을 나눈 뒤 전문 서브에이전트가 서로 다른 범위를 병렬 조사하고 결과를 다시 리드 에이전트로 반환합니다. 해당 시스템에 대한 공개 설명은 각 서브에이전트에 목표, 출력 형식, 사용할 도구와 작업 범위를 명확히 주는 것이 중복 작업과 조사 공백을 줄이는 데 중요하다고 설명합니다.
에이전트 역할을 분리했다면 도구와 권한도 역할에 맞춰 분리해야 합니다.
예를 들어 Research Agent에는 웹검색과 문서 검색 권한을 줄 수 있지만 게시 권한은 필요하지 않습니다. Writer Agent는 글을 생성하더라도 서버 삭제나 배포 권한까지 가질 이유가 없습니다. Publisher Agent만 실제 발행 API를 사용할 수 있도록 분리하는 방식이 더 명확합니다.
특히 외부 시스템을 변경하는 도구는 읽기 도구와 다르게 다뤄야 합니다.
게시, 이메일 발송, 데이터 삭제, 결제, 운영 서버 변경처럼 되돌리기 어려운 작업은 모델의 판단 한 번으로 바로 실행시키기보다 승인 단계와 권한 검사를 별도로 두는 구조가 적합합니다. Microsoft의 에이전트 보안 지침도 도구별 최소 권한, 행동별 권한 확인, 중요한 작업의 사람 승인, 도구 호출 감사 기록을 강조합니다.
그래서 팀 구조는 단순히
Agent → Tool
관계만 설계하는 것이 아니라
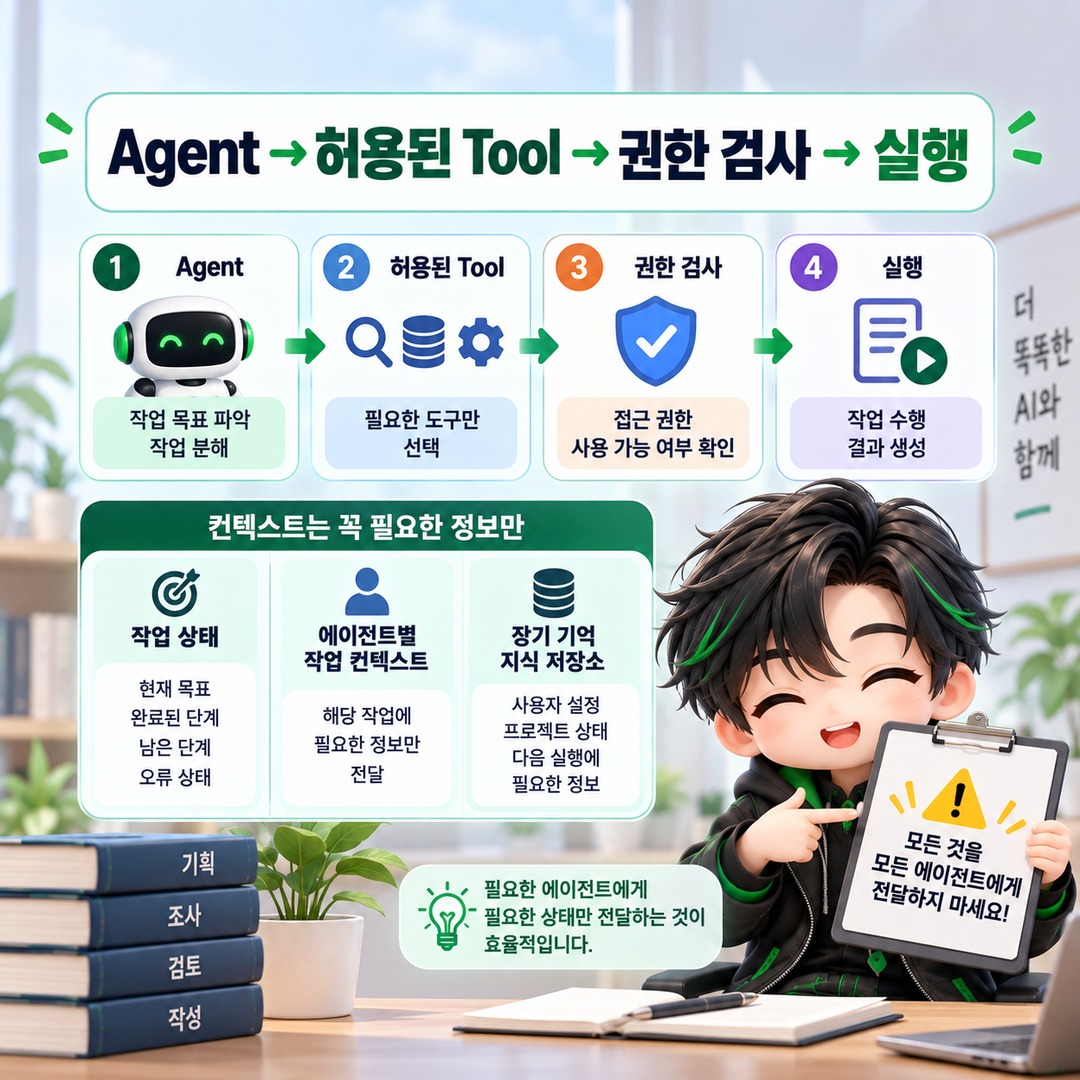
Agent → 허용된 Tool → 권한 검사 → 실행
까지 설계해야 합니다.
멀티에이전트 시스템에서 모든 에이전트에게 전체 대화와 모든 조사 결과를 계속 전달하면 컨텍스트가 빠르게 커지고 역할 경계도 흐려질 수 있습니다.
대신 세 층으로 나누는 방식이 이해하기 쉽습니다.
작업 상태에는 현재 목표, 완료된 단계, 남은 단계와 오류 상태를 저장합니다.
에이전트별 작업 컨텍스트에는 해당 에이전트가 지금 처리하는 데 필요한 정보만 전달합니다.
장기 기억 또는 지식 저장소에는 다음 실행에서도 필요한 사용자 설정이나 프로젝트 상태를 목적에 맞게 관리합니다.
기업 문서나 최신 데이터 자체를 무조건 장기 기억에 복사하는 방식도 주의할 필요가 있습니다. Microsoft의 멀티에이전트 참조 아키텍처는 메모리와 지식 소스를 구분하며, 공유 기업 콘텐츠는 권한을 적용해 필요할 때 검색하는 구조를 설명합니다.
핵심은 모든 에이전트가 모든 것을 기억하게 만드는 것이 아니라 필요한 에이전트에게 필요한 상태만 전달하는 것입니다.
에이전트끼리 긴 자연어 대화를 계속 주고받는 구조는 처음에는 편하지만, 오류가 생겼을 때 어느 단계에서 값이 잘못됐는지 추적하기 어려워질 수 있습니다.
가능한 부분은 구조화된 결과로 연결하는 편이 낫습니다.
Research Agent가 Writer에게 장문의 채팅 기록 전체를 넘기는 대신 다음과 같은 데이터 계약을 둘 수 있습니다.
확인된 사실
기준 시각
수치와 단위
적용 조건
예외
확인되지 않은 항목
원자료 식별 정보
Reviewer도 단순히 “좋습니다”라고 답하는 대신 `PASS`, `REVISE`, `BLOCK` 같은 상태와 수정 사유를 반환하도록 설계할 수 있습니다.
이렇게 하면 Manager가 다음 실행을 판단하기 쉬워지고, 같은 입력을 넣어 테스트할 때 실패 위치도 찾기 쉬워집니다.
멀티에이전트 시스템에는 명확한 종료 조건과 실행 한도가 필요합니다. “충분히 잘될 때까지 서로 검토하라”는 지시는 Reviewer와 Writer가 계속 결과를 주고받는 루프를 만들 수 있습니다.
AutoGen은 팀 실행에 메시지 수, 특정 종료 신호, 토큰 사용량, 시간 제한, handoff 등의 종료 조건을 둘 수 있도록 제공합니다.
실제 시스템에서도 종료 기준을 업무 조건으로 정의하는 편이 좋습니다.
예를 들어 콘텐츠 생성이라면 “필수 사실 필드가 모두 검증됐고 Reviewer가 PASS를 반환하면 종료”처럼 만들 수 있습니다. 반대로 핵심 자료를 찾지 못했다면 Writer에게 억지로 넘기지 않고 `BLOCKED`로 종료할 수 있습니다.
여기에 최대 실행 단계, 최대 비용 또는 토큰, 시간 제한을 별도로 두면 모델이 스스로 종료하지 못하는 경우에도 시스템이 실행을 통제할 수 있습니다.
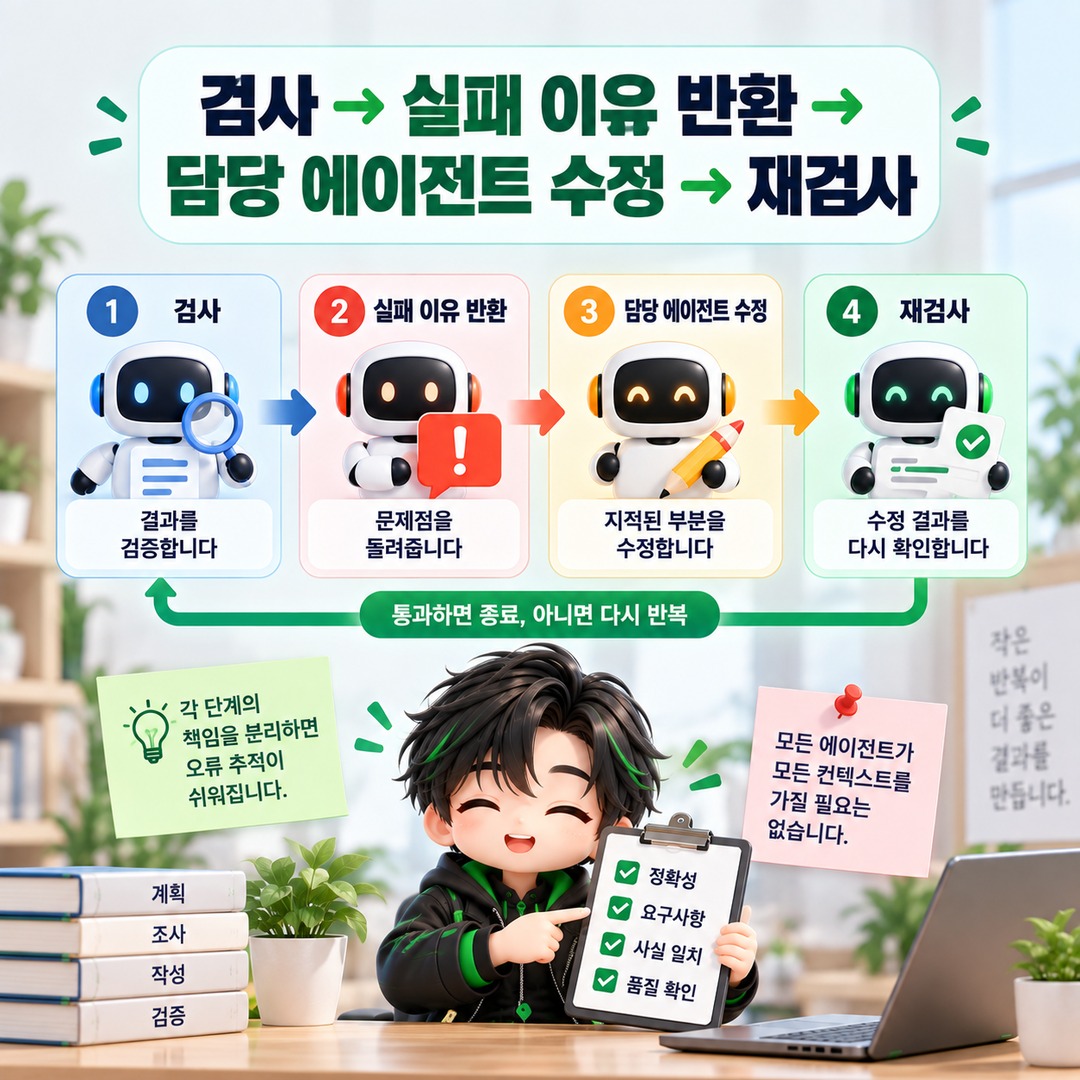
Reviewer Agent는 Writer보다 글을 더 잘 쓰는 두 번째 작가가 아니라 실패 조건을 찾는 에이전트로 만드는 것이 좋습니다.
예를 들어 정책 콘텐츠라면 날짜 불일치, 대상 조건 누락, 확인되지 않은 수치, FACT CORE 밖의 주장 등을 검사할 수 있습니다.
코딩 팀이라면 요구사항 충족 여부, 테스트 실패, 변경 범위 밖 수정, 정적 분석 오류 등을 담당하게 할 수 있습니다.
중요한 것은 Reviewer가 수정까지 전부 해버리지 않는 것입니다.
검사 → 실패 이유 반환 → 담당 에이전트 수정 → 재검사
처럼 책임을 분리하면 어느 단계에서 오류가 발생했는지 추적하기 쉽습니다.
OpenAI의 오케스트레이션 문서도 작업 에이전트와 평가 에이전트를 반복 실행하고 평가 조건을 통과하면 루프를 종료하는 코드 기반 패턴을 예로 들고 있습니다.
병렬화의 기준은 “에이전트가 많다”가 아니라 서로의 결과를 기다리지 않고 진행할 수 있는가입니다.
예를 들어 한 제품을 조사하면서 가격, 지원 환경, 공식 기능을 서로 다른 에이전트가 독립적으로 확인하는 작업은 병렬화하기 쉽습니다. 반면 앞 단계에서 결정된 데이터 구조를 받아 코드를 작성해야 하는 작업은 순차 의존성이 큽니다.
Anthropic이 공개한 Research 시스템은 복수의 독립적인 조사 방향을 탐색하는 작업에서 병렬 서브에이전트를 활용하지만, 모든 에이전트가 동일한 컨텍스트를 공유해야 하거나 의존 관계가 많은 업무는 멀티에이전트에 잘 맞지 않을 수 있다고 설명합니다.
따라서 “멀티에이전트니까 병렬 실행”이 아니라 독립 작업만 병렬화하고 의존 작업은 순서를 고정하는 것이 기준이 됩니다.
단일 에이전트가 제대로 작동한다면 굳이 팀으로 바꿀 필요는 없습니다. AutoGen 공식 문서도 단순한 작업은 먼저 단일 에이전트와 적절한 도구·지시를 최적화하고, 복잡한 협업과 다양한 전문성이 실제로 필요할 때 팀으로 전환하는 방식을 안내합니다.
팀 분리를 고려할 만한 신호는 비교적 명확합니다.
한 프롬프트에 서로 다른 업무 규칙이 지나치게 많이 들어간다.
조사와 작성처럼 서로 다른 도구가 필요한 작업이 섞여 있다.
일부 작업만 높은 권한이 필요하다.
독립적인 하위 작업을 동시에 실행할 수 있다.
결과 생성자와 검증자를 분리해야 한다.
어느 단계에서 오류가 발생했는지 추적하기 어렵다.
반대로 같은 정보를 공유하면서 순서대로 처리해야 하는 작은 작업이라면 단일 에이전트와 코드 워크플로가 더 단순할 수 있습니다.
첫 버전이라면 다음 구조로도 충분합니다.
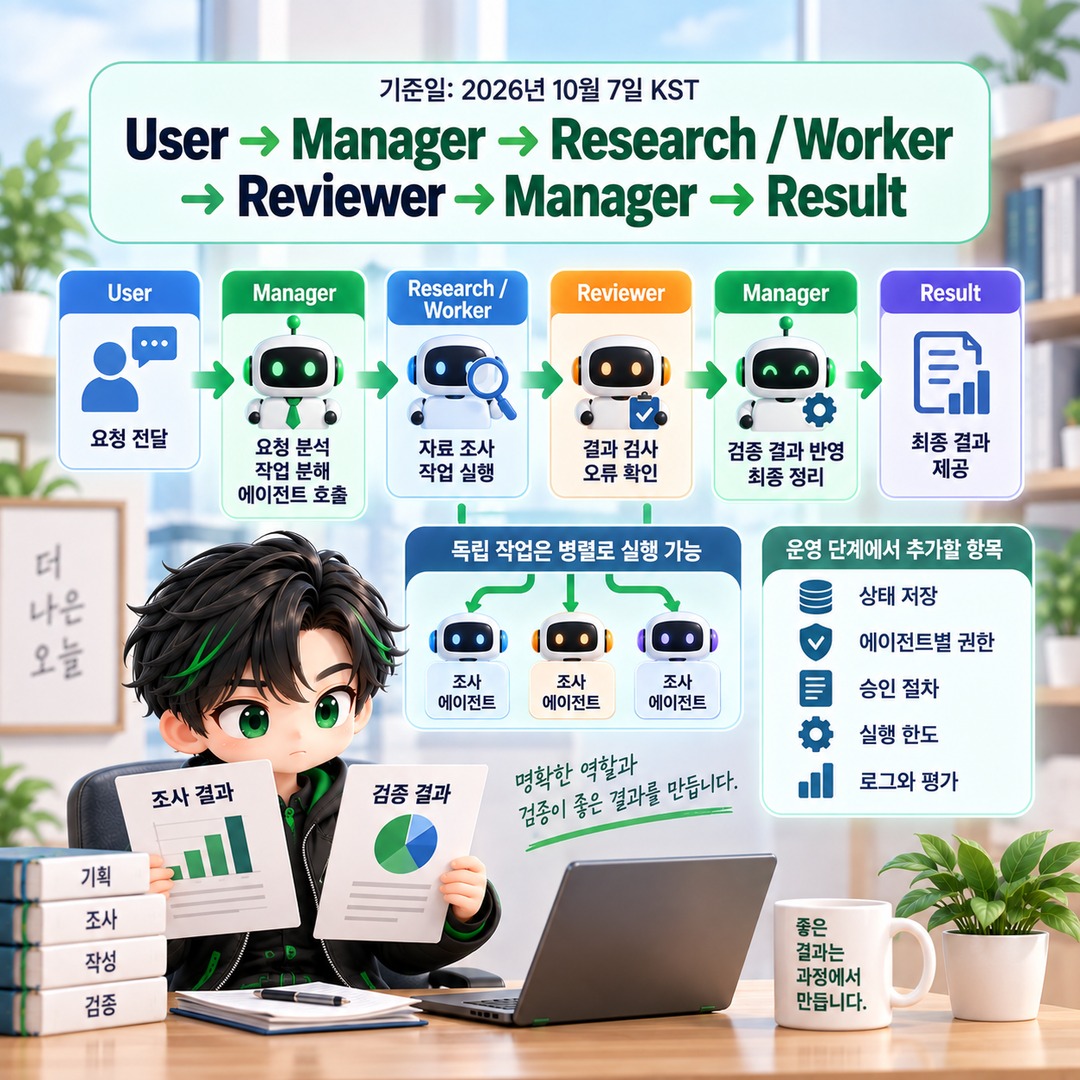
User → Manager → Research / Worker → Reviewer → Manager → Result
Manager가 요청을 분석하고 필요한 전문 에이전트만 호출합니다. 서로 독립적인 작업은 병렬로 실행하고, 의존성이 있는 단계는 코드에서 순서를 고정합니다. Reviewer가 결과를 검사하고 통과하면 Manager가 최종 결과를 반환합니다.
운영 단계에서는 여기에 상태 저장, 에이전트별 권한, 승인 절차, 실행 한도, 로그와 평가를 추가합니다.
새로운 문제가 생길 때마다 에이전트를 하나씩 늘리는 방식은 피하는 편이 좋습니다. 먼저 기존 역할과 다른 입력·도구·권한·평가기준이 실제로 필요한지 확인하고, 그 경계가 분명할 때 새 전문 에이전트로 분리하면 됩니다.
결국 좋은 LLM 에이전트 팀은 에이전트 숫자가 많은 시스템이 아닙니다.
누가 결정하고, 누가 실행하고, 무엇을 공유하며, 누가 검증하고, 어떤 조건에서 멈추는지가 명확한 시스템이 관리하기 좋은 에이전트 팀입니다.
가능합니다. 다만 모든 전문 도구를 Manager에 몰아주면 역할 분리의 장점이 줄어듭니다. 라우팅이나 공통 상태 확인에 필요한 도구는 Manager가 사용하고, 전문 작업에 필요한 도구는 해당 에이전트에 제한하는 방식이 관리하기 쉽습니다.
그럴 필요는 없습니다. 역할마다 필요한 추론 능력, 속도와 비용이 다를 수 있으므로 시스템 요구에 맞춰 모델을 다르게 배치할 수 있습니다. 다만 모델을 여러 종류로 나누는 것 자체가 목적이 되어서는 안 되며 실제 평가 결과를 기준으로 결정하는 것이 좋습니다.
자동으로 그렇지는 않습니다. 공유 대화 방식도 사용할 수 있지만 참여자가 늘어나면 조정과 종료 관리가 필요합니다. AutoGen 역시 여러 팀 패턴과 함께 실행 관찰 및 종료 조건을 별도로 제공합니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
관련 상품을 불러오고 있습니다…